Vibe Video Editingをやりたかった
はじめに
先日、所属する大学の学科が設立20周年を迎えました。
ここでイベントの様子とインタビュー映像を撮影したので、併せてこの映像の編集をすることになりました。
インタビュー映像だけでも1時間以上ある素材たちをできる限り短く、物語を編みながら、文字通り「編集」する必要があります。
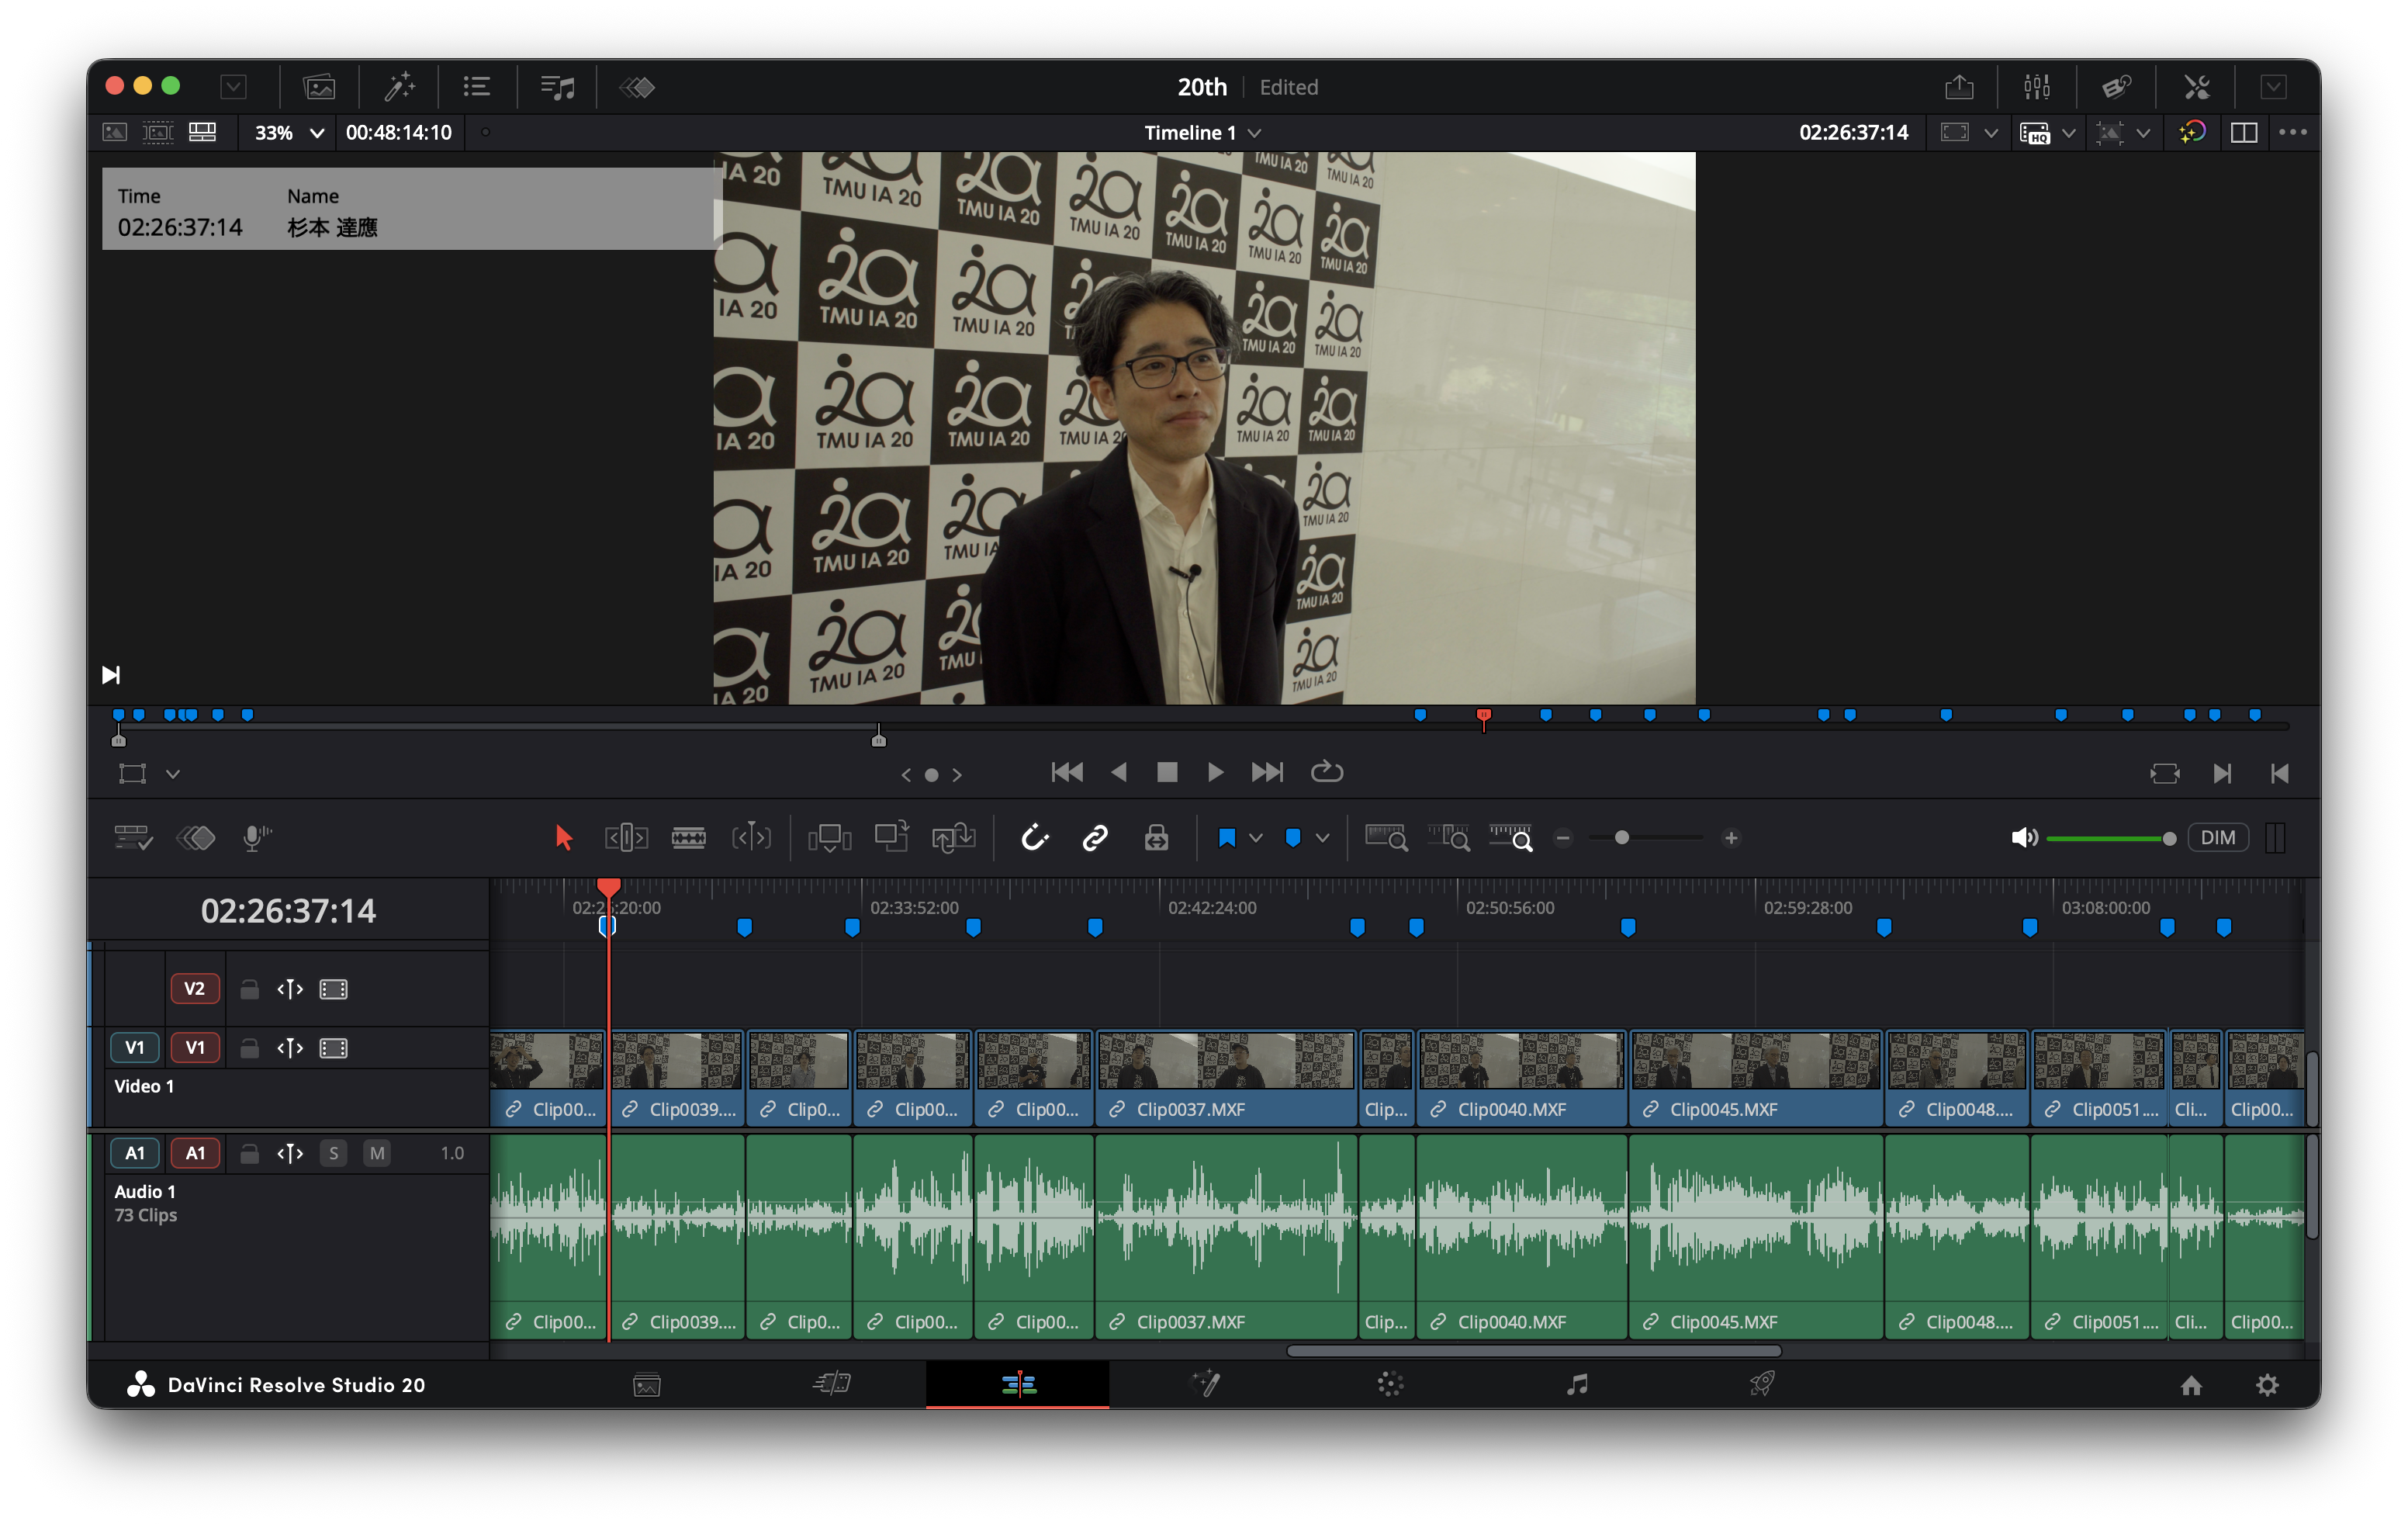 DaVinci Resolveでの編集画面
Vibe Codingによるコーディングが当たり前になった2026年、やりたい状態がふんわりとした要求で目の前で形になっていく日々。どんな作業にもこのノリを求めてしまう自分がいます。
元々何か固まっていないフローを一般化してシステム化するのが好きな自分にとっては、映像編集とVibe Codingが繋がって見えてしまいました。
言葉たちを再構成することによって1つの物語を作っていくこと、それを自然言語の処理を得意とするAIと共にできたら素敵だなと思い、さらにこれをフローとして確立できたら実験として面白いと思いました。
映像編集の領域ではまだAIによるサポートが少ないのが現状です。コーディングの分野では、操作者は自然言語の入力だけでソフトウェアが構築されていくのを眺めます。ここではAgentが直接ファイルを更新していきます。映像編集の分野でAIが利用されるのは、音声のSTTによる字幕生成や音声のノイズリダクション、一部の映像マスク処理の自動トラッキング程度。最近ではMCP経由での編集が可能になりつつありますが、まだ手作業が勝る状況にあります。つまり、映像編集分野におけるAIの利用は結局のところ音声、つまり自然言語の関わるところが実用の範囲内です。では、音声を元にした編集ならある程度は任せられるのではないでしょうか。
そう、それこそがインタビュー映像の再構成です。インタビュー映像は究極的に言えば文字情報に落とし込んで解釈することが可能です。
Vibe Video Editingのプロセス
データの準備と書き出し
目論見は以下の通りです。
- 事前準備
- インタビューにまつわる事前情報・インタビュイーの情報をMarkdownにまとめる(AIだのみ)
- 映像編集ソフト上での作業
- 不必要な処理や意図しない処理を避けるため最低限のカット処理を行う
- 話者ごとの区切りにマーカーを打ち、タイムコード上に話者情報を紐付ける → indexを書き出す
- STTによる字幕生成を行う → .srtファイルを書き出す
さて、これで3つのファイルが生成できました。インタビューの基本情報、話者情報の載ったタイムコード、字幕情報です。
インタビュー映像におけるエッセンシャルな部分を文字情報に落とし込むことができました。ここでAIの登場です。(ここまでにだいぶ手作業があるのはご愛嬌)
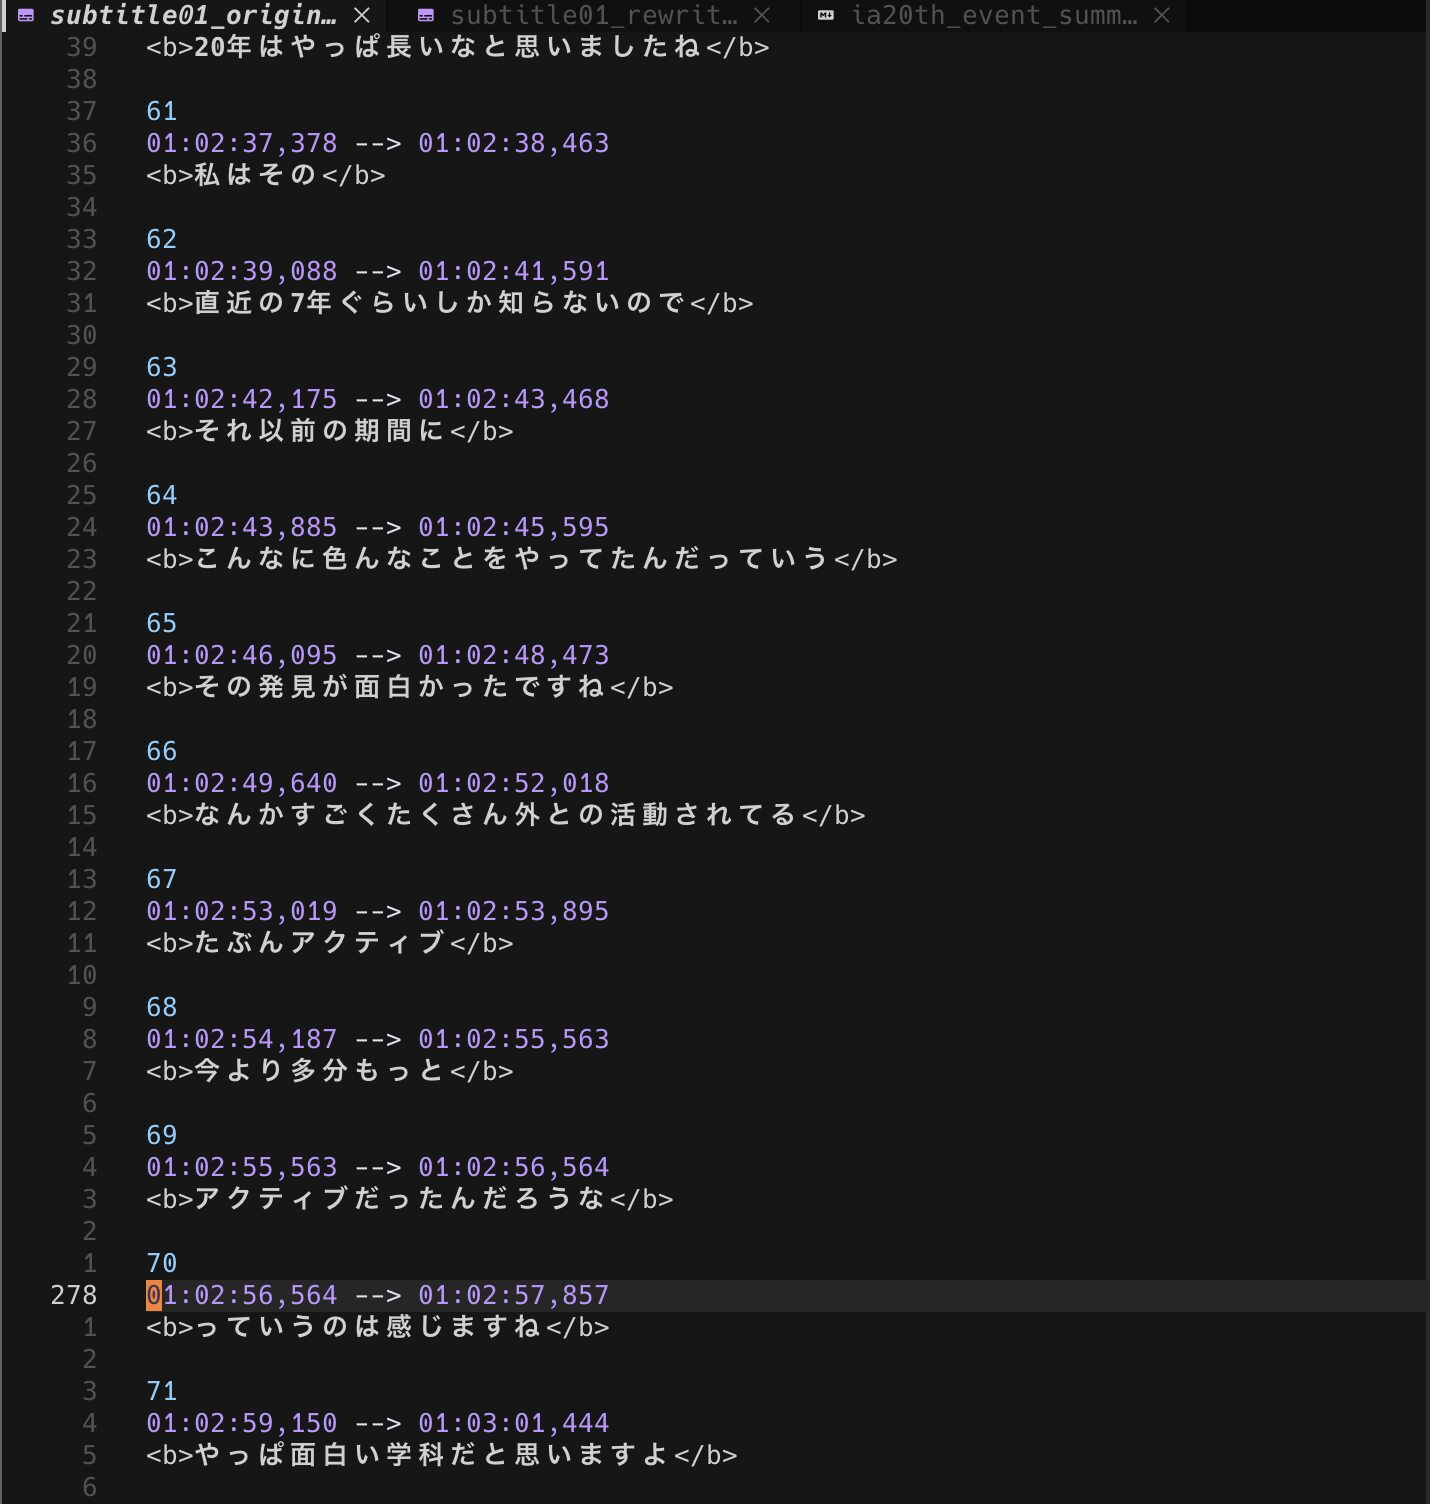 話者情報を含まないオリジナルの字幕データ
AIによるテキストデータの結合と整形
まずは話者情報と生成された字幕情報をタイムコードを使って結合します。
ここではもちろんAIを利用します。Agentに2つのファイルを指定して結合を行いました。
すべての字幕の冒頭にインタビュイーの名前を追記させることで、単一のファイルで話者と発話内容を紐づけることができました。
次に、発話内容の整形を行います。汎用なSTTでは誤認識や文脈の欠如によって不十分な文字起こしとなってしまいます。事前準備で作成した、インタビューの背景・インタビュイーの基本情報をまとめたMarkdownで、前段で示したsrtファイルを修正します。これにより、文脈に沿った文字起こしを作成することができました。また、ここでは不必要なフィラーなど、字幕として利用する上でノイズとなる情報も同時に削除しました。
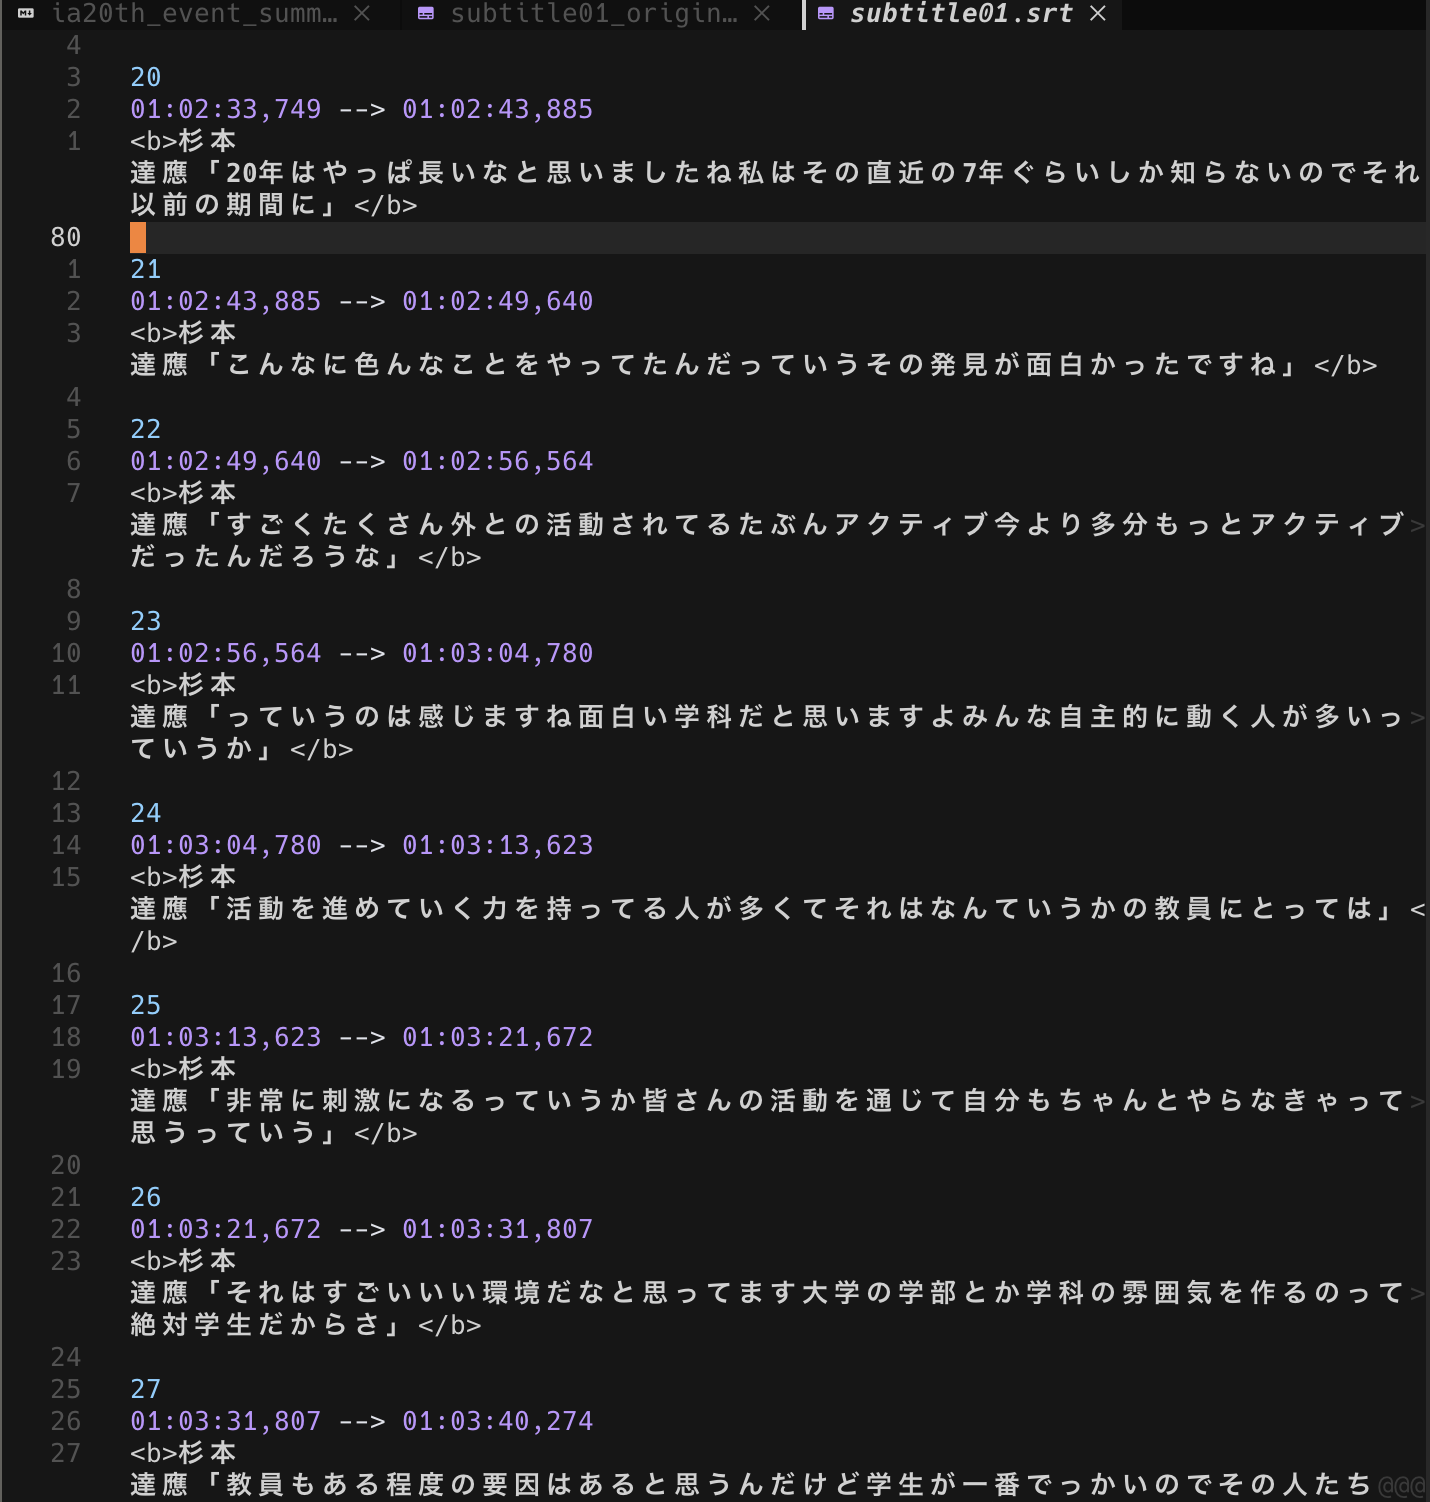 話者情報の追加・フィラー削除・整形が行われた字幕データ
文脈に沿った文字起こしが作成できたら、各インタビュイーがどのような内容を話しているのか、そのトピックをまとめてもらい、基本情報をまとめたMarkdownファイルに追記しました。これにより、誰がどのような内容の話をしたかが、その他の基本情報と共に1つのファイルにまとまりました。
AIによる構成案の作成と検証
さて、ようやく全ての準備が整いました。誰がどのような内容をどのタイムスタンプで話しているか、これらの情報全てが文字情報として揃いました。あとは自然言語処理マスターのAIくんによる物語の作成です。全ての情報が詰まったMarkdownを投げ、内容の再構成をお願いしました。
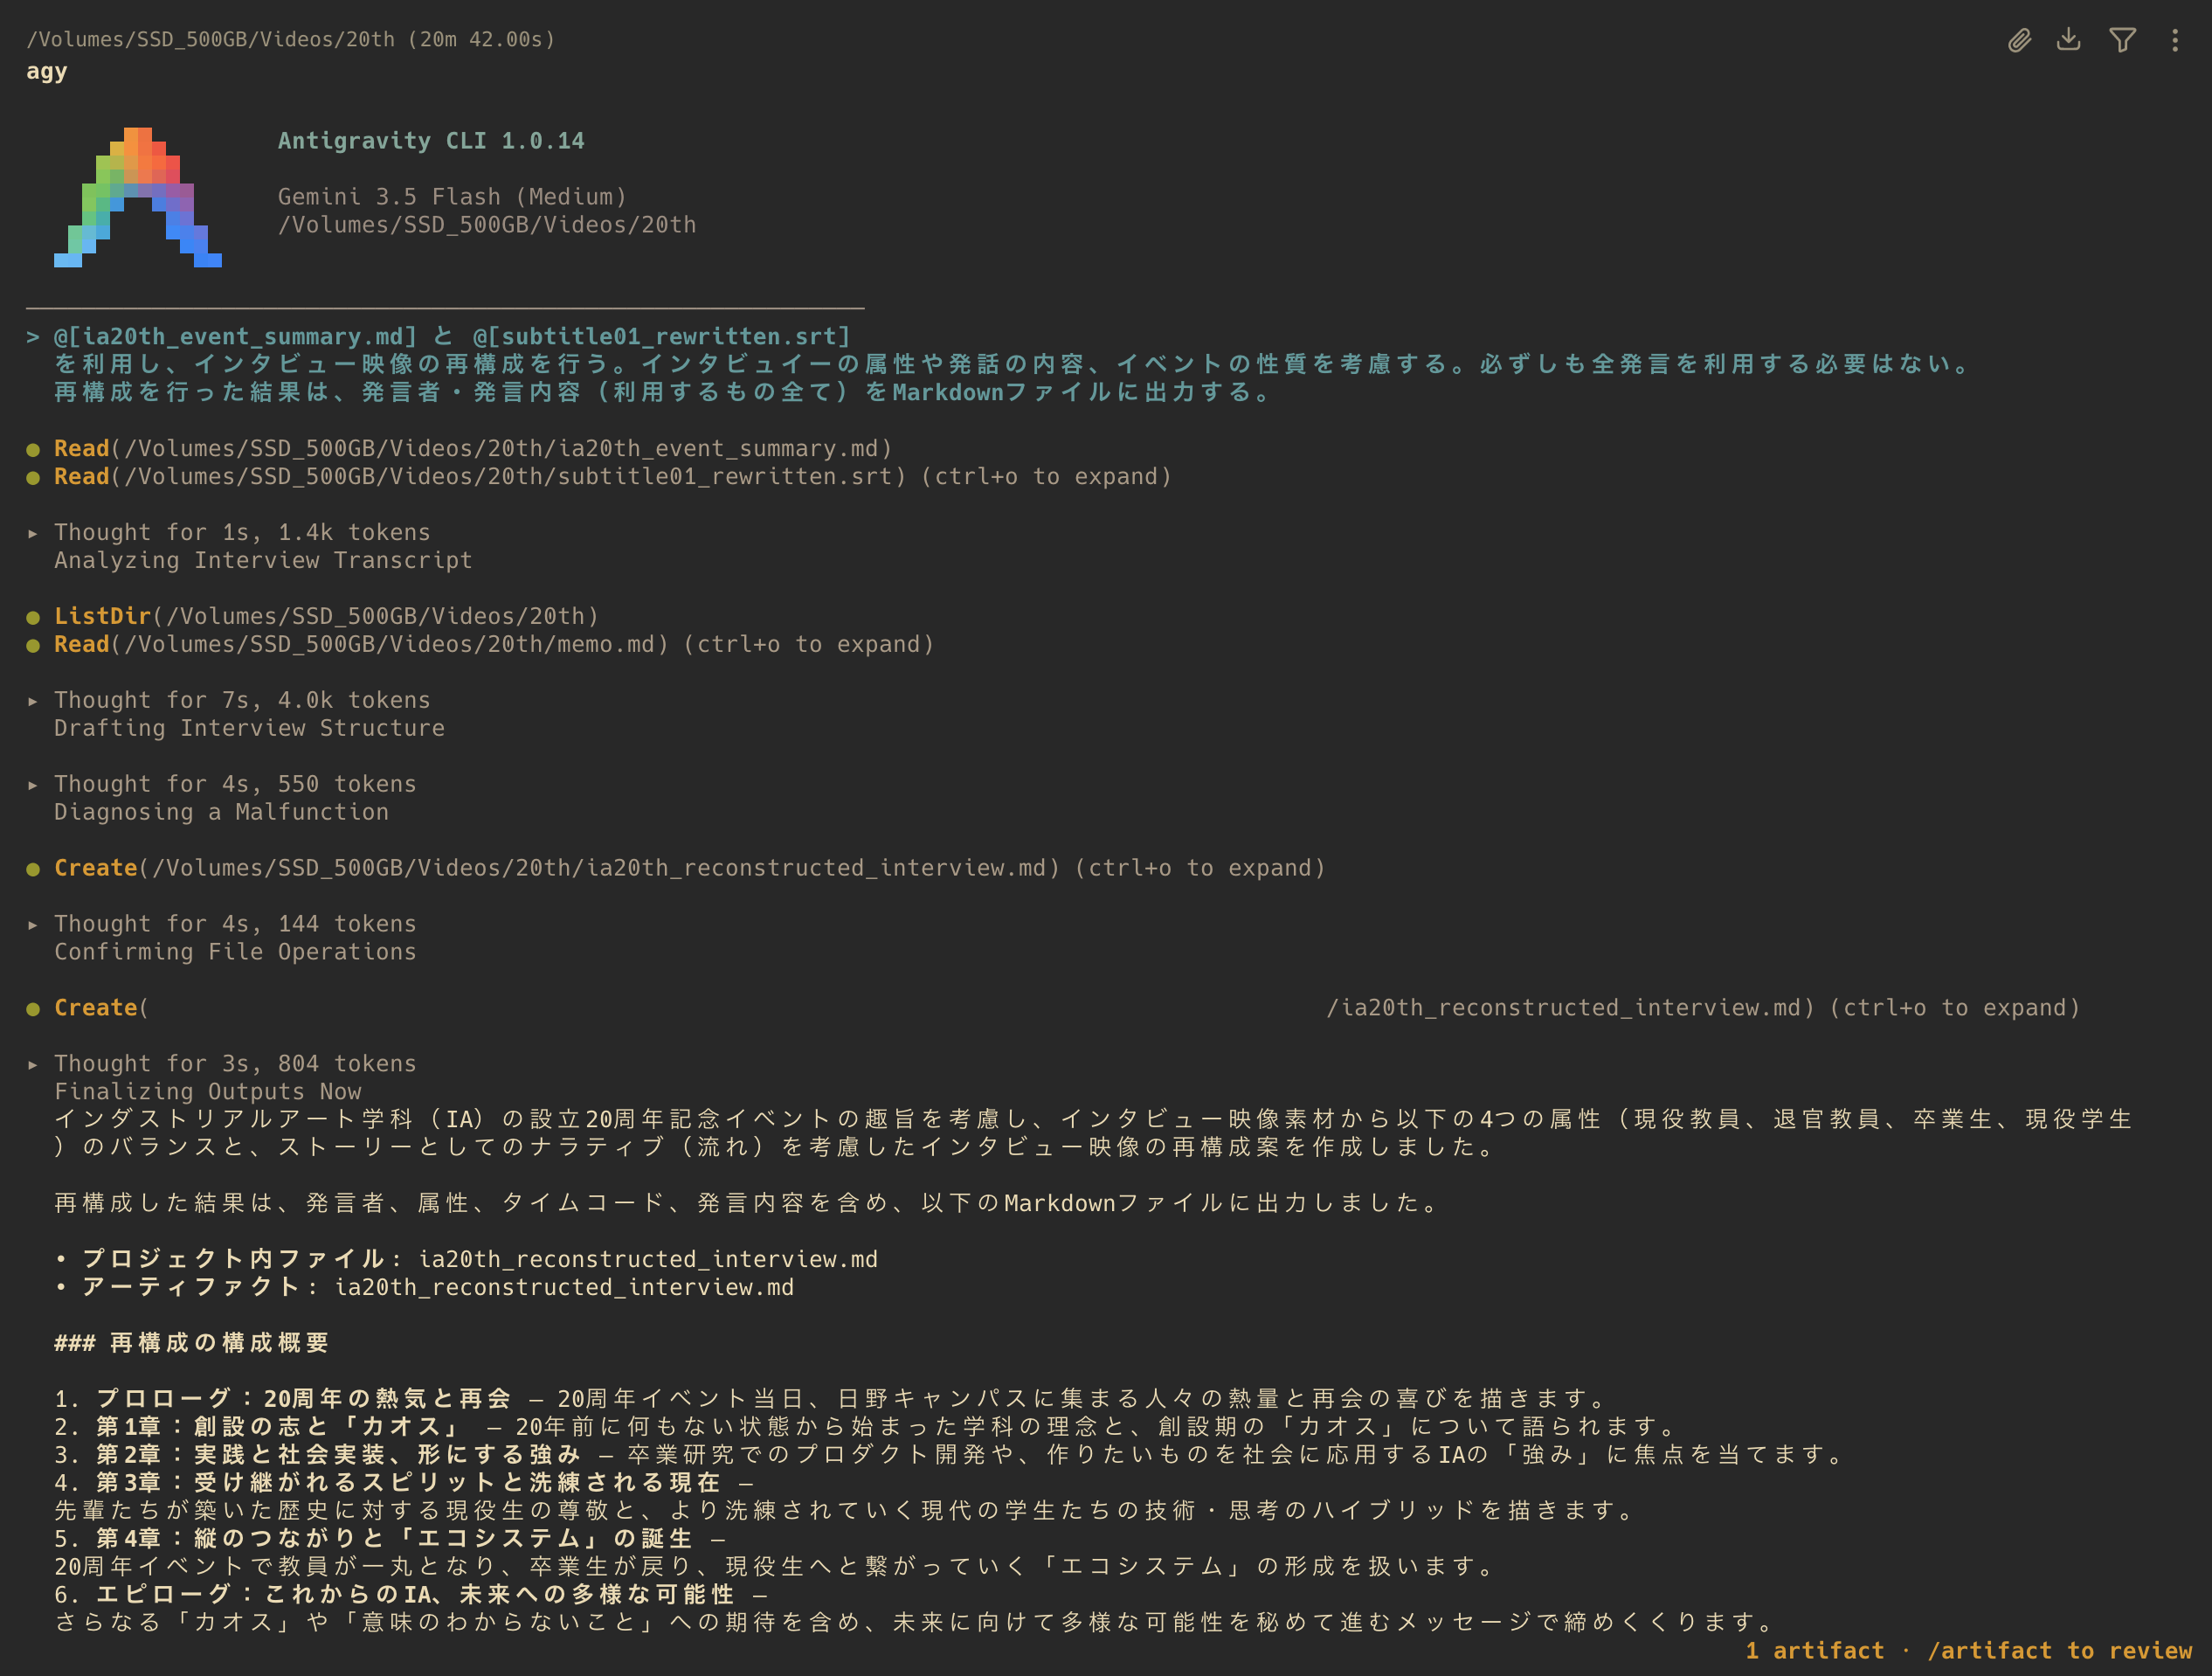 構成案作成のために準備されたMarkdown
結果は、「微妙」でした。
生成されたプロット(文脈の再構成)はぱっと見では流れがありましたが、文字情報からは取りこぼされているインタビュイーの性格や話し方、本来の意図などが汲み取りきれておらず、とってつけたような流れになってしまっていたのです。また、頼んでもいないのに「インサートとして〇〇の画を使う」など、ピッタリはまったインサートがある前提で話を進めてきたりして、絶妙に意思の疎通が図れませんでした。
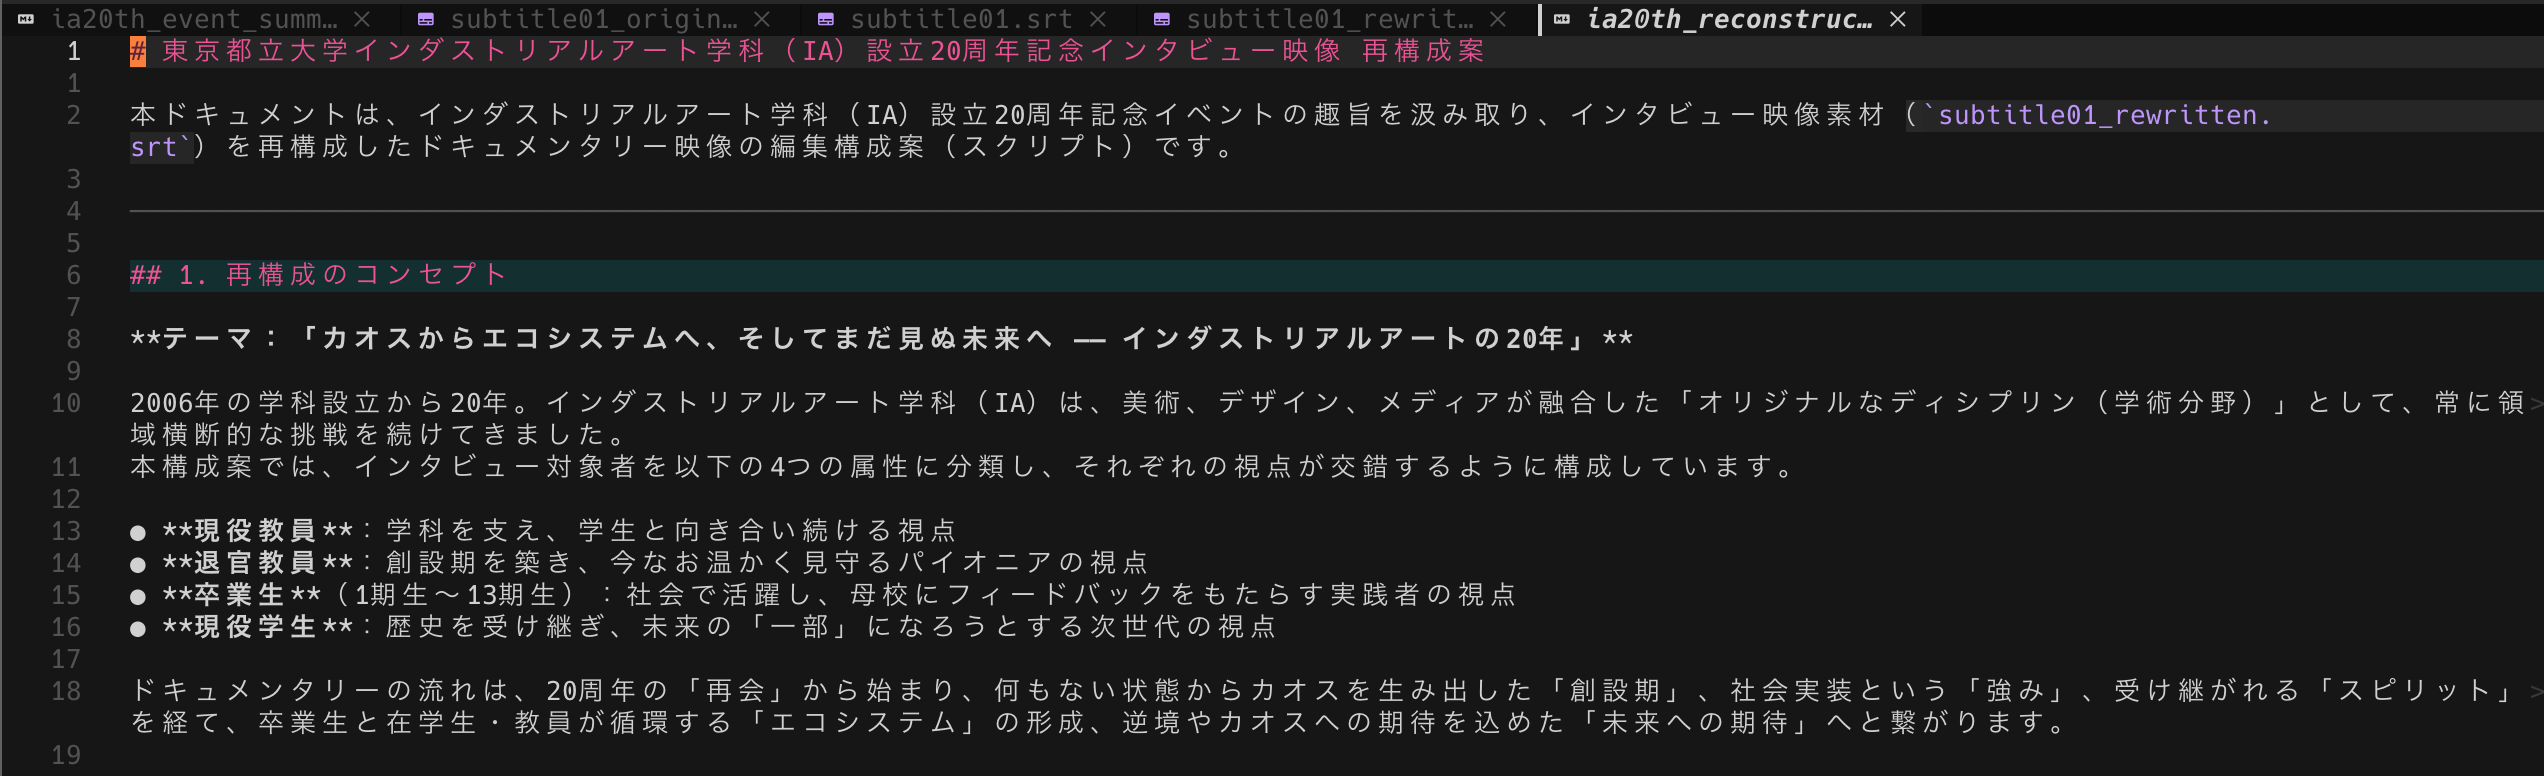 AIが提案した構成プロット
さいごに
かなりのステップのお膳立てをして目論んだVibe Video Editingでしたが、結果は失敗(というか、納得できない精度)でした。現状では、ビジュアルモデルは依然として多くの計算リソースを使うため、これ以上文字情報を超えたリクエストは諦めることとしました。
結局、すべての編集をいちから手作業で行い、1時間の素材は10分弱の映像となりました。
AIによるコーディングは自己増殖的にアップデートされる毎日ですが、映像編集で活躍できるのはまだ先のことになりそうです。